

Jev는 프로그램 안에 앉아 도장만 찍는 AI 심사관입니다. TypeSafe AI가 만든 이 모델은 ChatGPT나 Claude 같은 LLM(대형 언어 모델)과 달리 글을 쓰지 않습니다. 프로그램이 넘겨준 자료를 보고 "어느 쪽인가", "몇 점인가", "맞는가"에 정해진 형식으로 답하고, 그 답을 얼마나 확신하는지 함께 알려 줍니다.
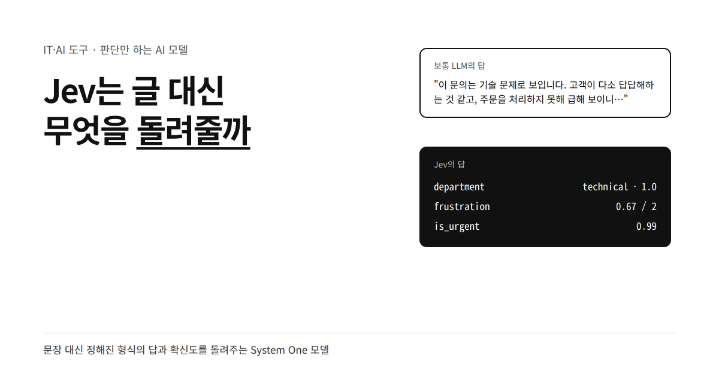
지금까지는 문의 분류처럼 간단한 판단도 LLM에게 맡기고, 길게 돌아온 답을 다시 코드로 해석해야 했습니다. 느리고 비싼 데다 답의 형식도 들쭉날쭉했습니다. TypeSafe는 Jev를 System One 모델이라고 부르는데, 사람이 몇 초 만에 내리는 직관적인 판단(시스템 1)을 소프트웨어 안에서 빠르게 대신하겠다는 뜻입니다. 이 글에서는 Jev가 LLM과 무엇이 다른지, 실제 코드로 어떻게 쓰는지, 어디에 쓰면 좋고 어디에 쓰면 안 되는지를 공식 문서를 바탕으로 정리합니다.
핵심 요약
- Jev는 문장을 만들지 않고, 고르기·점수·예/아니오 세 가지 질문에 정해진 형식의 답과 확률, 확신도를 돌려주는 판단 전용 AI 모델입니다.
- 회사 발표 기준으로 입력 100만 토큰당 0.042달러, 출력 무료, 응답 0.07~0.5초로 LLM보다 훨씬 싸고 빠릅니다.
- 문의 분류, 콘텐츠 필터, LLM 안전장치처럼 같은 판단을 많이 반복하는 곳에 맞고, 계산·날짜 비교·글쓰기는 코드나 LLM에 맡겨야 합니다.
LLM은 글을 쓰고 Jev는 판단만 합니다
프로그램에 LLM을 붙여 "이 문의가 환불 요청인가?"를 판단하게 하면, LLM은 답을 문장으로 돌려줍니다. 개발자는 그 문장에서 "예"인지 "아니오"인지 다시 뽑아내야 하고, 가끔 형식이 어긋나거나 엉뚱한 말이 섞이면 프로그램이 멈춥니다. 답이 나오기까지 몇 초씩 걸리고, 출력 글자 수만큼 비용도 듭니다.
Jev는 처음부터 이 용도에 맞춰 만들었습니다. 개발자가 가능한 답을 미리 정해 두면, Jev는 그 안에서만 답합니다. 보기에 없는 답을 지어내거나 형식을 어길 수 없으므로 답을 해석하는 코드가 필요 없습니다. TypeSafe는 이를 "프런티어급 지능을 가진 함수 호출"에 비유합니다. 정리되지 않은 자료가 들어가고, 타입이 정해진 판단이 나온다는 뜻입니다.
질문 하나에 정해진 형식의 답이 돌아옵니다
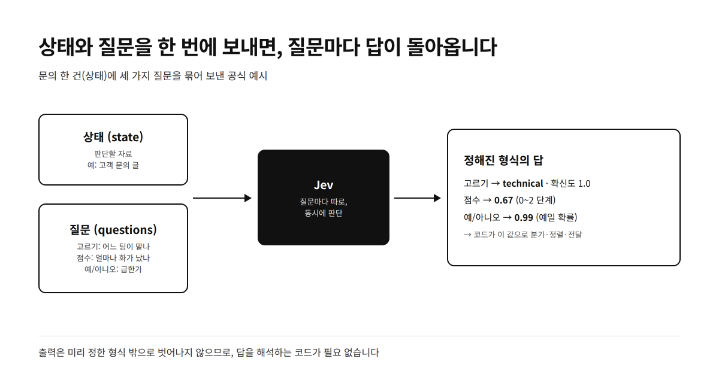
Jev에는 두 가지를 보냅니다. 판단할 자료인 상태(state)와, 그 자료에 대해 묻는 질문(questions)입니다. 질문은 세 종류이고, 한 번의 요청에 여러 개를 섞어 보낼 수 있습니다. 질문들은 서로 영향을 주지 않고 동시에 처리되므로, 질문을 늘려도 응답 시간은 거의 늘지 않습니다.
- Choice(고르기): 미리 정한 보기 중 하나를 고릅니다. 고른 답과 보기별 확률, 확신도를 돌려줍니다.
- Score(점수): 순서가 있는 기준표에서 어느 단계에 해당하는지 점수를 매깁니다.
- Noul(예/아니오): 어떤 문장이 맞는지 판단해, "예"일 확률을 0~1 사이 숫자로 돌려줍니다.
공식 빠른 시작 문서의 예시는 고객 문의 한 건에 세 가지를 동시에 묻습니다. 어느 팀이 맡아야 하는지, 고객이 얼마나 화가 났는지, 급한 일인지입니다. Python SDK(pip install typesafe-sdk)로 쓰면 다음과 같습니다.
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = "Our API integration started returning 500 errors on every request about 20 minutes ago, and we can't process any customer orders until this is fixed."

with TypeSafeClient(model="jev-latest") as client:  # TYPESAFE_API_KEY 환경 변수를 읽음
    response = client.system_one(
        state=ticket,
        questions={
            "department": Choice(
                instructions="Which team should handle this",
                criteria={
                    "billing": "Payment or subscription issues",
                    "technical": "Bugs or integration problems",
                    "sales": "Pricing or account questions",
                },
            ),
            "frustration": Score(
                instructions="How frustrated the customer appears",
                criteria=[
                    "Calm, just stating facts",
                    "Frustrated but civil",
                    "Very angry, strong language",
                ],
            ),
            "is_urgent": Noul(
                instructions="The message conveys urgency or time-sensitivity",
            ),
        },
    )

print(response.choices["department"].choice)   # technical
print(response.scores["frustration"].score)    # 0.67
print(response.nouls["is_urgent"].noul)        # 0.99
문서에 실린 결과는 담당 팀 technical(확신도 1.0), 불만 점수 0.67(0~2단계 중), 급함 확률 0.99입니다. 프로그램은 이 값을 그대로 받아 기술팀 대기열에 넣고, 급한 문의는 맨 앞으로 올리면 됩니다. JavaScript·TypeScript SDK(@typesafe-ai/sdk)와 일반 HTTP 요청(POST https://api.typesafe.ai/v1/systemone)으로도 같은 일을 할 수 있습니다. 공식 문서의 예시는 모두 영어이고, 한국어 처리 성능은 문서에 따로 나와 있지 않으므로 한국어 서비스에 쓰려면 직접 시험해 보는 것이 좋습니다.
확신도로 자동 처리와 사람 확인을 나눕니다

Jev의 가장 큰 특징은 확신도(confidence)입니다. 고르기와 점수 답에는 0~1 사이의 확신도가 붙습니다. 확률이 한 보기에 몰려 있으면 1에 가깝고, 여러 보기에 고르게 퍼져 있으면 0에 가깝습니다. 모델이 "이건 잘 모르겠다"고 말할 수 있어서, 프로그램은 확신도에 따라 다르게 움직일 수 있습니다.
공식 문서의 음성 뱅킹 예시는 사용자가 무엇을 원하는지 고르게 한 뒤, 확신도와 동작의 위험도를 함께 따집니다.
action = response.answers["intent"]

if action.confidence < 0.6:
    route_to_support_agent(account_id)          # 모델도 확신하지 못하면 상담원에게
elif action.choice == "check_balance":
    show_balance(account_id)                    # 잔액 조회는 틀려도 피해가 작음
elif action.choice == "approve_transfer":
    if action.confidence > 0.85:
        approve_transfer(account_id)            # 위험하지만 확신도가 높으면 자동 처리
    else:
        ask_user_to_confirm("송금을 승인할까요?")  # 애매하면 사용자에게 한 번 더 확인
기준값은 모델이 아니라 내 코드가 정합니다. 문서는 처음에는 보수적으로 잡고, 실제 데이터로 결과를 보며 조정하라고 권합니다. 예/아니오 질문에는 확신도가 따로 붙지 않으므로, 0.7 이상은 "예", 0.3 이하는 "아니오", 그 사이는 보류처럼 확률 자체로 나누는 것을 출발점으로 제시합니다.
실제로는 이런 곳에 씁니다
공식 문서의 활용 예시(쿡북)를 보면, Jev는 혼자 일하기보다 기존 프로그램이나 LLM 옆에서 빠른 판단을 맡는 부품으로 쓰입니다.
- LLM 안전장치: 챗봇에 들어오는 질문과 나가는 답변을 Jev로 먼저 검사합니다. 탈옥 시도인지, 위험한 내용인지 예/아니오 질문 여러 개로 묻고, 피해 정도를 점수로 매겨 통과·검토·차단을 코드로 나눕니다. 시스템 프롬프트에 규칙을 넣는 것보다 우회하기 어렵고, LLM을 한 번 더 부르는 것보다 싸고 빠릅니다.
- 댓글·채팅 필터: 메시지마다 욕설, 스팸, 스포일러, 질문 여부를 한 번의 요청으로 묻고, 결과에 따라 숨기거나 흐리게 하거나 강조합니다. 문서에는 트위치 채팅 필터 예시가 실려 있습니다.
- 검색 결과 거르기(RAG): AI 챗봇이 문서를 찾아 답할 때, 찾아온 문단마다 질문과 관련 있는지 점수를 매겨 관련 없는 문단은 LLM에 넘기지 않습니다.
- 인용 검증: AI가 쓴 글의 인용문이 원문 내용과 맞는지 고르기 질문 하나로 확인해, 지어낸 인용을 걸러 냅니다.
- 요청 분류: 사용자 요청을 분류해 단순한 것은 일반 코드로, 복잡한 것은 LLM으로, 민감한 것은 사람에게 보냅니다.
공통점은 같은 종류의 판단을 많이, 빠르게 해야 한다는 것입니다. 하루 수만 건의 문의나 댓글을 LLM으로 판단하면 시간과 비용이 크게 들지만, Jev는 판단 하나에 1초도 걸리지 않습니다.
계산과 글쓰기는 맡기면 안 됩니다
TypeSafe는 Jev 1.13의 약점을 문서에 직접 정리해 두었습니다. 가장 중요한 것은 숫자에 약하다는 점입니다. 글자 수 세기, 목록 개수 세기, 계산, 두 날짜 중 어느 것이 먼저인지 비교하는 일은 믿을 수 없으므로 코드로 처리하라고 안내합니다. 날짜라면 Jev는 문장에서 연·월·일을 뽑는 일만 하고, 비교와 계산은 코드가 맡는 식입니다.
또 질문을 글자 그대로 읽습니다. 사람이라면 의도를 짐작해 주겠지만, Jev는 적힌 조건만 따지므로 질문을 구체적으로 써야 합니다. 판단할 자료에 관련 없는 내용이 많으면 정확도가 떨어지므로, 필요한 부분만 골라 보내는 것이 좋습니다. 당연히 글, 코드, 요약은 만들 수 없습니다. 이런 일은 LLM에 맡겨야 합니다.
비용과 속도 수치도 감안해서 봐야 합니다. TypeSafe는 Jev가 같은 판단 작업에서 LLM보다 40~200배 빠르다고 발표했지만, 대부분 회사가 직접 측정한 결과입니다. 외부 검증은 아직 많지 않고, 모델 파일이 공개되지 않아 TypeSafe 서버를 통해서만 쓸 수 있다는 점도 기업 도입 때 따져 볼 부분입니다.
| 구분 | 내용 | 시사점 |
|---|---|---|
| 하는 일 | 상태와 질문을 받아 고르기·점수·예/아니오로 답함 | 답을 해석하는 코드 없이 바로 분기할 수 있습니다 |
| 확신도 | 답마다 0~1 확신도와 확률 분포 제공 | 자동 처리와 사람 확인을 코드로 나눌 수 있습니다 |
| 비용·속도 (회사 발표) | 입력 100만 토큰당 0.042달러, 출력 무료, 0.07~0.5초 | 대량 반복 판단에 유리하지만 외부 검증은 적습니다 |
| 잘 맞는 곳 | 문의 분류, 콘텐츠 필터, LLM 안전장치, 검색 결과 거르기 | LLM과 함께 쓰는 빠른 판단 부품입니다 |
| 약점 | 계산, 개수 세기, 날짜 비교, 글 생성 | 숫자는 코드, 글은 LLM에 맡겨야 합니다 |
정리하며
Jev는 글을 쓰는 대신 판단만 하는 AI 모델입니다. 판단할 자료와 질문을 보내면 미리 정한 형식의 답과 확신도를 돌려주므로, 프로그램이 그 값으로 바로 분기할 수 있습니다. 확신도가 낮을 때 사람에게 넘기는 구조를 쉽게 만들 수 있다는 점이 LLM으로 같은 일을 할 때와 가장 큰 차이입니다.
LLM을 대신하는 모델이라기보다, LLM과 기존 코드 사이에서 반복되는 판단을 싸고 빠르게 처리하는 부품으로 보는 것이 정확합니다. 문의나 댓글처럼 하루에 많이 들어오는 것을 분류해야 하는 서비스라면 시험해 볼 만하고, 숫자 계산이나 글쓰기는 지금처럼 코드와 LLM에 맡기면 됩니다.
원본: Jev · TypeSafe AI(2026년 9월 15일 공개) · 유료 API 서비스(공식 SDK는 MIT 라이선스) · typesafe.ai, 문서 docs.typesafe.ai. 가격과 버전, 예시 코드는 2026년 10월 26일 기준 공식 문서와 출시 블로그를 바탕으로 정리했습니다.
한마디로 정리하면
LLM이 질문하면 친절하게 설명해 주는 상담원이라면, Jev는 서류를 보고 도장만 찍는 심사관입니다. 심사관은 긴 설명을 하지 않습니다. "승인", "반려", "3등급" 중 하나를 찍고, 확실하지 않으면 "검토 필요" 칸에 넣습니다.
말이 없는 대신 아주 빠르고 인건비도 쌉니다. 그래서 하루에 서류가 수만 장씩 들어오는 곳에서는 상담원보다 심사관이 훨씬 잘 맞습니다. 다만 심사관에게 보고서를 써 달라고 하거나 금액 계산을 맡기면 안 됩니다. 그건 상담원과 계산기의 일입니다.
같은 판단을 많이, 빠르게, 그리고 "모르겠다"고 말할 줄 아는 방식으로 해야 할 때, 그 자리에 놓는 AI가 Jev입니다.
'IT·AI 도구' 카테고리의 다른 글
| AI 에이전트 샌드박스는 무엇이고 왜 필요할까? (0) | 2026.10.28 |
|---|---|
| REA는 에이전트로 앱을 어떻게 역공학할까? (0) | 2026.10.27 |
| UI 컴포넌트와 디자인 패턴은 어떻게 분류할까? (0) | 2026.10.26 |
| IndexedDB는 휴대폰에 데이터를 어떻게 저장할까? (0) | 2026.10.26 |
| 네이티브 앱과 웹서비스를 함께 운영하려면 어떻게 할까? (0) | 2026.10.26 |